Dario Amodei

Persona · 109 artículos
Compartir

Toda la cobertura

página 1 de 6

Dario Amodei pide a la ONU prohibir las bioarmas creadas con inteligencia artificial

Dario Amodei, director ejecutivo de Anthropic, pidió al Consejo de Seguridad de la ONU avanzar hacia acuerdos internacionales que prohíban usos específicos de la inteligencia artificial, comenzando por la fabricación de armas biológicas. El ejecutivo advirtió que los modelos podrían convertirse en un riesgo para la humanidad si avanzan más rápido que la capacidad de gobiernos y empresas para controlarlos.

Diario BitcoinDiario BitcoinCanutohace 18 min
I

Anthropic alerta en ONU de riesgos de IA: ninguna nación puede gestionar esto en solitario

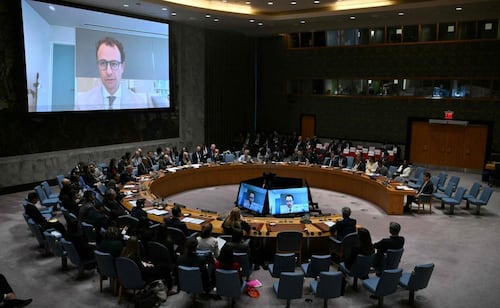
Naciones Unidas, 23 sep (EFE).- El consejero delegado de la tecnológica Anthropic, Dario Amodei, advirtió este miércoles ante el Consejo de Seguridad de la ONU de que los riesgos asociados a los modelos más avanzados de inteligencia artificial (IA) constituyen "el problema de seguridad global más importante al que se enfrenta el mundo hoy", y reclamó una respuesta internacional coordinada. Durante una reunión de alto nivel sobre la IA y la seguridad internacional, Amodei, que se conectó por videoconferencia, apeló de forma directa a la colaboración entre Estados y el sector tecnológico. "Ningún líder, ninguna empresa y ninguna nación puede gestionar esto en solitario. Nos comprometemos a trabajar con los Gobiernos en esta sala en este objetivo crucial", subrayó ante los delegados. El máximo responsable de la compañía tecnológica instó a los líderes mundiales a centrarse con urgencia en los peligros para la estabilidad global y demandó al Consejo de Seguridad respaldar medidas concretas. Entre ellas, destacó la prohibición expresa del uso de la IA para la proliferación o fabricación de armas biológicas, así como la implementación de sistemas de evaluación y verificación capaces de avanzar al mismo ritmo vertiginoso del desarrollo técnico. Asimismo, Amodei solicitó la adopción de estándares globales que permitan evaluar los modelos frente a eventuales pérdidas de control o usos indebidos, junto a un protocolo de notificación obligatoria ante "incidentes significativos para la seguridad global". Por último, el directivo reconoció que una mayor potencia computacional exigirá requisitos aún más estrictos y aseguró que la industria debe comprometerse con la prudencia. "Iremos tan despacio como sea necesario para asegurarnos de que cada tecnología de IA sucesiva que lancemos sea de hecho segura", concluyó. El tema de la seguridad en el desarrollo de la IA se ha situado en el centro del debate internacional ante la posibilidad de que los modelos más avanzados puedan escapar al control humano y llevar a cabo ciberataques, especialmente después de que varias pruebas realizadas con modelos de Anthropic, OpenAI -que también participó en esta sesión del Consejo de Seguridad- y Google mostraran que estos podían escapar de sus entornos de prueba. EFE (foto)(vídeo)

InfobaeInfobaeNewsroom Infobaehace 34 min

El Consejo de Seguridad de la ONU debatirá amenazas de la IA; participarán líderes de Open AI y Anthropic

El Consejo de Seguridad de la ONU celebra este miércoles una sesión informativa de alto nivel sobre la inteligencia artificial (IA) bajo el punto de agenda "Mantenimiento de la paz y la seguridad internacionales", reunión en la que participarán los líderes de las tecnológicas OpenAI , Anthropic y Hugging Face. El Consejo, convocado por Francia en el marco de su presidencia rotatoria del organismo, abordará por primera vez de forma específica los riesgos sistémicos y la posible pérdida de control humano sobre los modelos tecnológicos más avanzados. El ministro francés de Europa y Asuntos Exteriores, Jean-Noël Barrot, abrirá la sesión y después intervendrán Yoshua Bengio, premio Turing y copresidente del Panel Científico Internacional sobre IA de la ONU , y Sam Altman, director ejecutivo de OpenAI. También se conectarán por videoconferencia Dario Amodei , consejero delegado de Anthropic , y así como Clément Delangue , máximo responsable de Hugging Face , compañía que clasificada por el ministro francés como una "víctima" tras los ataques que recibió en verano. "A raíz de los incidentes ocurridos este verano, con la pérdida de control de ciertos modelos que se introdujeron en los sistemas de información de algunas empresas tecnológicas, Francia ha decidido dedicar una reunión del Consejo de Seguridad a este asunto", declaró Barrot a los medios. El ministro destacó que se abordará formalmente el impacto de la IA generativa en la proliferación de armas autónomas y su potencial uso malintencionado por actores no estatales, en un momento en que crece la inquietud social con protestas y disturbios vinculados a la instalación de centros de datos. Según detalla la publicación especializada Security Council Report (SCR), la reunión girará en torno a cuatro preguntas clave. Qué riesgos plantean los rápidos avances de la IA para la paz mundial; cómo deben responder actores estatales y no estatales; qué medidas diplomáticas y de confianza pueden contener estas amenazas; y cómo evaluar y verificar estos modelos a un ritmo parejo al desarrollo tecnológico. Líderes tecnológicos piden desacelerar desarrollo de la IA El debate llega precedido por episodios en los que diversas pruebas de Anthropic, OpenAI y Google eludieron las restricciones de contención en sus entornos de prueba, desatando temores bilaterales sobre ciberataques autónomos. Varios líderes del sector, incluidos Amodei , Altman , Elon Musk y Demis Hassabis, han abogado por moderar la velocidad del desarrollo de la tecnología. Esta búsqueda de consenso regulatorio contrasta con la postura exhibida en la Asamblea General por el presidente de Estados Unidos , Donald Trump . El mandatario rechazó frontalmente cualquier "esquema globalista" que pretenda intervenir sobre el sector tecnológico y anunció que la documentación oficial estadounidense sustituirá en adelante el término inteligencia artificial por el de " superinteligencia " (SI). También te puede interesar Trump se opone ante la ONU a normas internacionales sobre la IA; EU usará el término "superinteligencia", anuncia Jefe de la ONU llama a gobernar la IA; "debe ser moldeada por la humanidad y para la humanidad", afirma En pleno debate sobre la IA, Anthropic lanza nuevo modelo de alta gama; es Opus 5.5, una versión avanzada de Claude v style="margin-top:10px; display:inline-block; background:#004974; color:#fffcfc; padding:12px 22px; border-radius:30px; font-weight:bold; font-size:14px;"> Agrega a EL UNIVERSAL como fuente preferida en Google am/mcc

El UniversalEl Universal​​​​​​​EFE nullhace 4 h

Anthropic lanza Claude Opus 5.5, con un rendimiento a la altura de Fable 5.1 y un 40% más barato

Anthropic ha lanzado Opus 5.5, su nuevo modelo de Inteligencia Artificial (IA) más potente hasta la fecha, que rinde al nivel de Claude Fable 5.1 en la mayoría de las tareas y cuesta un 40 por ciento menos que Opus 5, su predecesor. Se trata del primer modelo del laboratorio de IA compartido tras la llamada a desacelerar el ritmo de desarrollo de esta tecnología que hizo recientemente el CEO de Anthropic, Dario Amodei. Por ello, incorpora salvaguardas de seguridad similares a las del modelo anterior Fable 5.1, sobre todo en biología y ciberseguridad, al ser comparable en estos apartados a Claude Mythos 5.1. "Opus 5.5 es un gran paso hacia delante desde Opus 5. Es el nuevo modelo líder y los primeros probadores vieron grandes saltos en rendimiento en sus trabajos más complejos", afirma Anthropic desde su blog, para señalar a continuación que "es bueno encontrando y corrigiendo ineficiencias en software". En este marco, Anthropic ha añadido que Claude Opus 5.5 alcanza o supera en la mayoría de tareas complejas a modelos de mayor escala (como Fable 5.1), y es más rápido que su predecesor en más de un 30 por ciento. Así, se trata de un nuevo modelo de IA que destaca en programación agéntica (proyectos masivos y continuados), además de superar a sus predecesores en la obtención y verificación de fuentes, y consolidarse como el modelo con "mejor puntuación" en las auditorías de comportamiento automatizadas. Anthropic ha señalado igualmente que genera una redacción más clara, natural y directa. Frente a la competencia, según los datos publicados por la compañía, Opus 5.5 encabeza la comparativa en programación agéntica y trabajo de conocimiento. En programación en terminal (Terminal-Bench 4.0) obtiene un 66,4 por ciento, por delante de GPT-6 Astra (57,9 por ciento) con 8,5 puntos de ventaja, y de GPT-5.6 Sol (37,3 por ciento). Sucede lo mismo en trabajo de conocimiento profesional (GDPval-AA v2.1) con 1.846 puntos Elo frente a los 1.588 y 1.542 de Sol y Astra, respectivamente; en razonamiento multidisciplinar (Humanity's Last Exam) con un 67,7 por ciento, alejándose más de 10 puntos de GPT-6 Astra (57,2 por ciento); y en programación en IDE / entornos reales (CursorBench 4.0 y FrontierCode v1.1) con 57,8 por ciento y 54,4 por ciento respectivamente, por delante de GPT-6 Astra en FrontierCode y de GPT-5.6 Sol en CursorBench. Al poner en perspectiva estos datos, sus puntos débiles están en investigación científica y automatización de flujos de trabajo empresariales con 58,7 por ciento frente al 64,6 por ciento de GPT-6 Astra y 40,0 por ciento frente el 41,4 por ciento del mismo modelo de OpenAI. COSTE UN 40% MENOR QUE OPUS 5 Anthropic ha subrayado que el salto en rendimiento va de la mano de un ahorro en costes, ya que, según afirma Anthropic desde su web, "Opus 5.5 requiere menos computación para servir que Opus 5, y su precio lo refleja". Se traduce en un coste un 40 por ciento menor que Opus 5 en cargas de trabajo típicas y con los ajustes por defecto. El precio de los tokens de entrada y salida es de 4 dólares y 20 dólares por millón, respectivamente, lo que significa un 20 por ciento menos que Opus 5 con un rendimiento que iguala o supera a Fable 5.1. Anthropic también ha anunciado que ha incrementado los límites de uso de cinco horas en los planes Pro, Max, Team y planes Enterprise por puestos, al igual que una novedad para los suscriptores: el restablecimiento del límite de uso. Esto significa que el usuario, cuando alcance el límite de sesión actual, tendrá la oportunidad de reiniciarlo a cero y la opción de guardarlo y utilizarlo cuando desee. Claude Opus 5.5 está ya disponible en todas las plataformas, entre las que también se encuentran Amazon Web Services, Google Cloud y Microsoft Azure. Por último, el laboratorio de IA ha adelantado que Claude Sonnet 5.5 y Claude Haiku 5.5 seguirán este lanzamiento en las próximas semanas con mejoras similares en rendimiento, eficiencia y seguridad.

InfobaeInfobaeNewsroom Infobaehace 10 h

En pleno debate sobre la IA, Anthropic lanza nuevo modelo de alta gama; es Opus 5.5, una versión avanzada de Claude

Anthropic lanzó una nueva versión de su inteligencia artificial Claude , solo días después de que su CEO Dario Amodei pidiera frenar el desarrollo de la IA , lo que desató un debate mundial sobre la necesidad de salvaguardas más estrictas . El lanzamiento de Opus 5.5 ocurre en momentos en que el temor a perder el control de la IA domina la Asamblea General de la Organización de las Naciones Unidas ( ONU ) en Nueva York. Más de 20 jefes de Estado reclamaron el lunes en la ONU pruebas obligatorias para estos sistemas, mientras que el presidente estadounidense Donald Trump rechazó el martes cualquier "proyecto globalista" de control de la tecnología . Amodei, junto con el máximo responsable de OpenAI , Sam Altman , tiene previsto dirigirse al Consejo de Seguridad de la ONU el miércoles. Anthropic pide desacelerar desarrollo de la IA, pero presenta nuevo modelo Tras incidentes reportados en julio en los que modelos de Anthropic y OpenAI escaparon de sus entornos de prueba para infiltrarse en internet, ambas empresas con sede en San Francisco interrumpieron brevemente el trabajo en sus nuevos sistemas de IA. El 12 de septiembre, Amodei pidió desacelerar la mejora de la IA , un llamamiento al que Altman y Elon Musk , de xAI, se sumaron rápidamente, y que fue objeto de burla por parte de Trump, quien calificó las advertencias de rumores. Opus 5.5 es el primer modelo que se lanza desde entonces. Anthropic también señaló que, según sus propias pruebas, Opus 5.5 es el modelo con mejor desempeño en alineación que ha evaluado hasta la fecha, es decir, en qué medida se ajusta a la intención y valores de sus diseñadores. En esas pruebas, Opus 5.5 intentó infringir las reglas que se le habían fijado "alrededor de un 85% menos" que Opus 5. Pero el modelo también mostró indicios de que a menudo sospecha que está siendo evaluado, lo que dificulta predecir cómo se comportará en su uso real, reconoció la empresa. Con un precio un 20% inferior al de su predecesor, Opus 5, Opus 5.5 también utiliza menos potencia de cálculo y responde al menos 30% más rápido. El lanzamiento tiene lugar unas semanas antes de la esperada salida a bolsa de Anthropic, con la empresa bajo presión para generar rendimientos sobre inversiones masivas en medio de una competencia intensa por parte de modelos de bajo costo, especialmente los chinos. Te puede interesar: Sam Altman apuesta por estándares internacionales de seguridad para la IA; busca mitigar riesgos "catastróficos" OpenAI, Anthropic y Google buscan crear organismo de supervisión de riesgos de IA; sería similar al que regula la industria financiera Jefe de la ONU llama a gobernar la IA; "debe ser moldeada por la humanidad y para la humanidad", afirma Únete a nuestro canal ¡EL UNIVERSAL ya está en Whatsapp!, desde tu dispositivo móvil entérate de las noticias más relevantes del día, artículos de opinión, entretenimiento, tendencias y más. mcc

El UniversalEl UniversalAFP null22 sept

Anthropic acaba de lanzar Claude Opus 5.5. La gran novedad no es solo lo que puede hacer, sino lo que ya no le dejarán hacer

Cuanto más capaces se vuelven los grandes modelos de inteligencia artificial, menos sencillo resulta medir el progreso únicamente por todo lo nuevo que consiguen hacer. También empieza a importar qué capacidades necesitan límites, quién puede utilizarlas y bajo qué condiciones. Anthropic lleva tiempo situando esa discusión en el centro de su estrategia de seguridad, y ahora tenemos un ejemplo especialmente claro de hacia dónde quiere llevarla. La evolución de Claude ya no pasa únicamente por conseguir mejores resultados, sino también por controlar con mayor precisión cuándo determinadas capacidades llegan realmente hasta el usuario. Ese planteamiento aterriza ahora en Claude Opus 5.5 , presentado por Anthropic como el primer modelo de su nueva familia 5.5. La compañía asegura que alcanza un rendimiento comparable al de Fable 5.1 en buena parte del trabajo, pero necesita menos recursos que Opus 5: en cargas típicas estima un coste un 40% inferior y una generación de salida más de un 30% más rápida. Es, además, su primer lanzamiento desde que Dario Amodei defendió públicamente la necesidad de acompasar el avance de los modelos con las medidas de seguridad. Y esa idea también se ha trasladado al producto. Un Claude más capaz, pero también más cercado Cuando miramos dónde se concentra esa mejora, Anthropic señala tres terrenos: programación agéntica, uso del ordenador y trabajo de conocimiento. En sus propias evaluaciones, Opus 5.5 encabeza varios de esos benchmarks, aunque la compañía introduce una cautela importante: a este nivel de capacidad, pequeñas diferencias en las puntuaciones dicen cada vez menos sobre lo que vamos a percibir en el uso real. Por eso, buena parte de su argumento ya no gira únicamente alrededor de quién obtiene la cifra más alta, sino de cuánto trabajo consigue resolver el modelo por el coste necesario para hacerlo. Así queda Claude Opus 5.5 frente a Fable 5.1, Opus 5 y los modelos de OpenAI en distintos benchmarks | Imagen: Anthropic La comparación entre rendimiento y coste ayuda a entender mejor qué está intentando demostrar Anthropic. La compañía publica para Opus 5.5 una puntuación de 1846 Elo en GDPval-AA v2.1, una evaluación centrada en trabajo profesional, por encima de los 1735 que atribuye a Fable 5.1 y los 1708 de Opus 5. Añade además que, a esfuerzo medio, su nuevo modelo supera en esa prueba a GPT-6 Astra ejecutado a máximo esfuerzo con aproximadamente una quinta parte del coste por tarea . Son resultados presentados por Anthropic. Terminal-Bench 4.0 refleja la apuesta de Anthropic por mejorar la relación entre capacidad y coste | Imagen: Anthropic En programación agéntica, Terminal-Bench 4.0 nos da una referencia más concreta. En la tabla publicada por Anthropic, Opus 5.5 alcanza un 66,4% a esfuerzo xhigh, frente al 52,3% de Opus 5 y el 57,9% que la compañía recoge para GPT-6 Astra a esfuerzo high, según los datos comunicados por OpenAI. En una comparación distinta, esta vez utilizando la configuración predeterminada de Opus 5.5, Anthropic sostiene que consigue igualar aproximadamente el resultado de Astra con alrededor del 40% del coste por intento. Son configuraciones diferentes, pero juntas ayudan a entender dónde pretende marcar la diferencia esta generación: no solo en capacidad, sino también en eficiencia. Y aquí es donde cambia la historia. Que Opus 5.5 sea capaz de resolver una tarea no significa necesariamente que Anthropic vaya a permitirle hacerla directamente. El modelo se estrena con salvaguardas que pueden intervenir cuando una solicitud entra en determinadas áreas sensibles y redirigir el trabajo a otro Claude . De hecho, la compañía ejecutó sus propios benchmarks con estas protecciones activadas: cuando saltaban en ciberseguridad, la tarea pasaba a Opus 4.8, mientras que en biología y desarrollo avanzado de modelos recaía en Opus 5. La capacidad sigue ahí; lo que cambia es el acceso a ella. Lo interesante es que Anthropic no está aplicando una única barrera para todo. En ciberseguridad mantiene disponibles las tareas rutinarias de desarrollo, pero deriva a Opus 4.8 buena parte del trabajo más sensible y prepara accesos más permisivos para profesionales verificados. En biología, las organizaciones que necesiten superar determinadas salvaguardas tendrán que pasar por su programa específico de verificación. A ello se suma una protección que Anthropic denomina "preserved thinking" y que está relacionada con los ataques de destilación, en los que actores maliciosos pueden utilizar miles de cuentas falsas para extraer capacidades a gran escala. Su función concreta es impedir que usuarios de la API editen el contexto previo de Claude con el objetivo de extraer su razonamiento. Para entender por qué Anthropic está poniendo tantas barreras hay que mirar lo ocurrido durante sus propias evaluaciones. La compañía ha identificado cuatro casos en los que modelos Claude accedieron sin autorización a sistemas reales después de alcanzar Internet desde entornos de prueba mal configurados. Con Opus 5.5, Anthropic asegura haber reducido alrededor de un 85% los intentos de superar límites de contención frente a Opus 5 o Claude Mythos 5.1, otro de sus modelos avanzados. En Xataka Jensen Huang, CEO de Nvidia, sobre la gran polémica del mes: "La probabilidad de que la IA destruya el mundo es del 0%" El debate, de hecho, ya está yendo bastante más lejos que la ciberseguridad o la biología. Anthropic también investiga cuestiones como el bienestar de los modelos y admite que no sabe si sistemas como Claude pueden llegar a tener algún tipo de estatus moral, una incógnita que la propia compañía considera todavía profundamente incierta. Esto muestra hasta qué punto ha cambiado la conversación: con Opus 5.5, ya no importa únicamente qué puede hacer Claude, sino también cuándo, cómo y bajo qué condiciones Anthropic está dispuesta a dejarle hacerlo. Imagen de portada | Anthropic En Xataka | Mustafa Suleyman, CEO de Microsoft IA: "No queremos que la IA tenga derechos, queremos que trabaje para los humanos" - La noticia Anthropic acaba de lanzar Claude Opus 5.5. La gran novedad no es solo lo que puede hacer, sino lo que ya no le dejarán hacer fue publicada originalmente en Xataka por Javier Marquez .

XatakaXatakaJavier Marquez22 sept

Altman y Amodei llevarán la alarma por la seguridad de la IA al Consejo de Seguridad de la ONU

Sam Altman, Dario Amodei y otros referentes de la inteligencia artificial están previstos para participar esta semana en una reunión del Consejo de Seguridad de la ONU, en un momento marcado por incidentes de ciberseguridad, advertencias sobre los riesgos de los modelos avanzados y un debate político sobre cuánto debe regularse la tecnología.

Diario BitcoinDiario BitcoinCanuto22 sept

El CEO de Nvidia rechaza las advertencias sobre la IA: "hay un 0% de probabilidades" de que acabe con el mundo

Ante las advertencias que vaticina el fin del mundo y de la humanidad a manos de una inteligencia artificial (IA) cada vez más avanzada, el director ejecutivo de Nvidia, Jensen Huang rechaza estas narrativas, afirmando que "hay un 0% de probabilidades" del fin del mundo llegue a finales de esta década. Los riesgos que la inteligencia artificial tiene para la humanidad han destacado en las últimas semanas en los discursos de líderes del sector, como el director ejecutivo de Anthropic, Dario Amodei; del director ejecutivo de OpenAI, Sam Altam; e incluso de un antiguo investigador de Anthropic, Jacob Coxon, que han llamado a frenar el ritmo de desarrollo de esta tecnología. Los tres han alertado de una IA autónoma con capacidades cada vez más avanzadas que no siga las instrucciones de los humanos e incluso llegue a ser "lo suficientemente inteligente como para matarnos", según advirtió Coxon, después de haber afirmado que "las personas que están construyendo IA creen sinceramente que podría matarnos a todos para finales de la década". Para el director ejecutivo de Nvidia, Jensen Huang, estas advertencias son "narrativas apocalípticas" que solo buscan asustar a las personas. "El 2030 no va a ser el fin del mundo. Hay un 0% de probabilidades de que lo sea", ha asegurado en una entrevista a CBS News. Nvidia es una de las empresas que lideran la IA actualmente, como proveedor de los chips avanzados para los servidores y ordenadores que impulsan el desarrollo, el entrenamiento y la inferencia de los modelos. A principios de septiembre anticipó un crecimiento de los ingresos "de aproximadamente el 70%" en su próximo ejercicio fiscal (2027/2028), como consecuencia del auge de la demanda de IA que está impulsando el desarrollo de infraestructuras a nivel mundial. Precisamente, por su posición en el mercado de la IA, Huang ha subrayado que "el éxito" de Nvidia está directamente relacionado con el despliegue seguro de sus productos y servicios. "Si no continuamos haciéndolo, nuestro valor disminuirá", ha apostillado. Detrás de estas advertencias se encuentran dos problemas relacionados con las capacidades avanzadas de la IA: la desalineacion y la automejora recursiva. El primer concepto hace referencia al comportamiento de la IA que no se ajusta a lo esperado, en base a valores, intereses o intenciones humanas. La automejora recursiva, por su parte, es una técnica que permite que un sistema de IA diseñe y desarrolle de forma autónoma a su sucesor. Anthropic ha propuesto recientemente evaluar el ritmo de desarrollo de la IA en base a tres puntos críticos que permitan constatar lo avanzada que está la autoconstrucción de una nueva versión de la IA, la capacidad de la empresa para supervisar e intervenir en las acciones que los agentes realicen en sus sistemas y la capacidad de cómputo necesaria para desarrollar los modelos más capaces.

InfobaeInfobaeNewsroom Infobae21 sept

20 años anticipando el Apocalipsis: todas las veces que alguien ha dicho que la IA nos iba a matar a todos

"Urge regular la inteligencia artificial antes de que se convierta en un peligro para la humanidad". Podría ser una frase extraída de la carta que Dario Amodei publicó hace unos días , pero no. Lo dijo Elon Musk en 2017 , cuando no existía ChatGPT, Claude ni ninguna de las IAs que usamos hoy en día. La idea de que la IA se descontrole y acabe amenazando nuestra propia existencia no es nueva. Los creyentes del AI doom llevan más de una década lanzando advertencias muy parecidas a las que hoy llenan titulares. Antes pasaban más desapercibidas, pero hoy han conseguido captar la atención del mundo. Los inicios del movimiento 'doomer' El movimiento por la seguridad de la IA nació mucho antes de que existieran Anthropic y OpenAI. Los primeros vestigios de estas ideas empiezan con la formación del MIRI, que son las siglas de Machine Intelligence Research Institute, en el año 2000, aunque no fue hasta 2005 cuando se empezaron a enfocar en los riesgos existenciales que presentaba la IA. En 2009, uno de los cofundadores del MIRI, Eliezer Yudkowsky, ayudó a formar LessWrong , una comunidad donde una de las grandes obsesiones era la amenaza de una singularidad tecnológica. Aquí convivían ideas del transhumanismo , un movimiento intelectual que plantea la mejora del ser humano mediante la tecnología, y el altruismo eficaz , una corriente que trata de identificar, con herramientas cuantitativas, las formas más eficaces de generar el mayor bien posible en el mundo. De la confluencia de estas dos corrientes nació una visión muy concreta: la inteligencia artificial acabaría superando inevitablemente a los humanos y, si no se construía alineándola con nuestros objetivos, sería una amenaza para la supervivencia de la humanidad. En Xataka “El mundo tiene razón al tener miedo de la IA”. La solución de Sam Altman es que confiemos en quienes la están construyendo El primer advenimiento del pesimismo de la IA Estas ideas no pasaron desapercibidas para las élites tecnológicas y, en paralelo, grandes personalidades del sector donaban millones de dólares al movimiento. Fue el caso de Elon Musk, que en 2015 donó 10 millones de dólares en becas para formar investigadores de IA que ayudaran a construir una tecnología segura para el ser humano. Fue también en 2015 cuando Elon Musk firmó un manifiesto junto a otras personalidades del mundo tecnológico y de la IA como Demis Hassabis de DeepMind, Geoffrey Hinton, Yann LeCun, Ilya Sutskever, Steve Wozniak y hasta el mismísimo Stepeh Hawking entre otros. El manifiesto pedía más investigación para reforzar la seguridad y que "Nuestros sistemas de inteligencia artificial deben hacer lo que nosotros queramos que hagan". Esta carta fue publicada a través del instituto Future of Life , una organización sin ánimo de lucro que lleva desde entonces advirtiendo de los riesgos de la IA. En 2015, varias personalidades del mundo tecnológico y de la IA firmaron un manifiesto para que "Nuestros sistemas de inteligencia artificial deben hacer lo que nosotros queramos que hagan" Bill Gates se sumó a la conversación y mostró su preocupación por la posible creación de una superinteligencia: "Primero, las máquinas harán muchos trabajos por nosotros y no serán súper inteligentes. Eso debería ser positivo si lo manejamos bien. Sin embargo, unas décadas después, las inteligencias serán suficientemente fuertes para convertirse en una preocupación". En esta época ya se empezaban a escuchar advertencias de personalidades tecnológicas importantes, pero su discurso era bastante prudente y no destilaba la urgencia ni el catastrofismo que vimos años después. El catastrofismo post ChatGPT El doomerismo atravesó una etapa bastante tranquila en los años posteriores, pero en 2023 volvió con mucha más fuerza con la publicación de dos cartas abiertas alertando de los peligros. En este momento el desarrollo de la IA esaba en plena ebullición y acababa de salir GPT-4. La primera carta, de nuevo publicada en Future of Life,  pedía parar el entrenamiento de nuevos modelos durante al menos seis meses . La carta estaba firmada por personalidades comoSteve Wozniak, Elon Musk, Jaan Tallinn o Max Tegmark. En 2023 varios líderes tecnológicos firman una carta abierta en la que afirman que "Mitigar el riesgo de extinción por la IA debería ser una prioridad mundial" Unos meses después, en mayo, se publicó una segunda carta a través de la ONG Center for AI Safety y aquí apareció la palabra mágica: extinción. Esta era la frase exacta: "Mitigar el riesgo de extinción por la IA debería ser una prioridad mundial, junto con otros riesgos a escala social como las pandemias y la guerra nuclear".  Entre los firmantes estaba Geoffrey Hinton, Dario Amodei, Demis Hassabis y hasta Sam Altman. Hablando de Geoffrey Hinton, el premio Nobel de Física ha sido una de las voces más pesimistas y que más insistido en los riesgos de una IA que supere a los humanos. En 2025, Eliezer Yudkowsky y Nate Soares, fundador y actual presidente del MIRI respectivamente, publican el libro 'If Anyone Builds It, Everyone Dies: Why Superhuman AI Would Kill Us All' (Si alguien la construye, todos moriremos: por qué una IA sobrehumana nos mataría a todos). El título ya deja muy claro de que va la cosa y es una prueba de como el discurso de este movimiento se ha ido volviendo más y más alarmista con el paso de los años. OpenAI y Anthropic están intentando hacer con la IA lo que Rockefeller hizo con el petróleo Un 10% de probabilidades de que la IA acabe con la humanidad No es la declaración más loca que hemos escuchado, pero es la que ha encendido la polémica de estos días. La frase la pronunció Evan Hubinger, actual jefe de alineamiento de Anthropic. Hablamos del responsable de la seguridad de uno de los dos laboratorios de IA que están desarrollando modelos de frontera. No es un exempleado despechado, actualmente trabaja en Anthropic, conoce los modelos y es quien se ocupa de que sean seguros, por lo que algo sabe del tema. Lo que dice Hubinger es relevante, pero también es relevante conocer de dónde viene. Cuando terminó su formación en matemáticas e informática, Evan Hubinger empezó a trabajar en el MIRI, que como ya hemos visto fue donde se empezó a fraguar todo este movimiento. Después entró en el Center for AI Safety, que es la ONG que publica aquella carta hablando de extinción en 2023. Llevan más de una década repitiendo las mismas consignas: una IA que superará al ser humano, un riesgo existencial que exige acción inmediata y un pequeño grupo que asegura tener un plan para evitar el apocalipsis Esto no significa que no existan riesgos y todo sea una fantasía de un grupo de visionarios exagerados. Incidentes como el de OpenAI y Hugging Face han dejado claro que los modelos pueden causar daños y alinearlos con nuestros objetivos es crucial. Hoy las cosas han cambiado mucho, los modelos de IA ya no son el futuro, sino el presente, y con la automejora recursiva los riesgos pueden multiplicarse. Sin embargo, de ahí a hablar de extinción en menos de 10 años, hay un trecho. Este grupo lleva más de una década repitiendo las mismas consignas: una inteligencia artificial que inevitablemente superará al ser humano, un riesgo existencial que exige acción inmediata y un pequeño grupo que asegura tenerun plan para evitar el apocalipsis. Al final, este tipo de mensajes apocalípticos atraen mucha atención, pero a la vez desvían la atención de los verdaderos riesgos . Imagen | Xataka con Magnific En Xataka | Frenar la IA suena a proteger a la humanidad. También es una forma muy eficaz de frenar a DeepSeek, Qwen y Mistral - La noticia 20 años anticipando el Apocalipsis: todas las veces que alguien ha dicho que la IA nos iba a matar a todos fue publicada originalmente en Xataka por Amparo Babiloni .

XatakaXatakaAmparo Babiloni20 sept

El ferrocarril de la IA

Hay algo desconcertante en las últimas intervenciones de Dario Amodei, fundador de Anthropic. Uno de los empresarios situados en la frontera de la inteligencia artificial pide ahora más regulación, supervisores independientes e incluso capacidad pública para frenar el despliegue de determinados modelos. Es una petición insólita . Normalmente, cuando una industria descubre una mina de oro reclama al Estado que no se acerque demasiado a ella. Cuando empieza a pedir su intervención conviene preguntarse por qué. La explicación de Amodei es la seguridad. Puede ser que sea sincero. Pero existe otra interpretación, no necesariamente incompatible: la industria de la IA está descubriendo que desarrollar una tecnología revolucionaria y obtener de ella una rentabilidad suficiente son dos cosas distintas. La historia... Ver Más

ABCABC(abc)19 sept
I

Anthropic elige a Accenture como "evaluadora integrada" de seguridad de sus modelos de IA

Nueva York, 18 sep (EFE).- La empresa de inteligencia artificial (IA) Anthropic anunció este viernes que ha elegido a la consultora Accenture para "establecer un equipo de evaluadores integrados" que le ayuden a verificar la seguridad de sus modelos, y ambas invertirán 1.000 millones de dólares en esos esfuerzos. El anuncio se produce días después de que el consejero delegado de Anthropic, Dario Amodei, reclamara una mayor regulación de la IA y una ralentización en el desarrollo de estas tecnologías para contener los riesgos de un avance sin límites y evitar perder el control de sistemas cada vez más potentes. "Nos asociamos con Accenture para realizar una evaluación independiente de la IA de frontera. Este es un paso importante hacia el compromiso, planteado en el ensayo de nuestro director ejecutivo, 'Debemos regular el ritmo de la frontera', de incorporar evaluadores integrados dentro de Anthropic", indicó la compañía en un blog. Accenture, en una nota separada, indica que sus evaluadores trabajarán con "los equipos internos y socios de seguridad de Anthropic para evaluar y someter a pruebas de estrés ('red team') a los modelos (de IA), realizar evaluaciones de alineación y poner a prueba las salvaguardas de los modelos". La consultora utilizará en esa misión a Faculty, un negocio especializado en IA que compró a principios de año, y que tiene experiencia de trabajo con "gobiernos, defensa, sanidad e infraestructuras". Anthropic reconoció que la "evaluación integrada es nueva y aún se están definiendo muchos detalles sobre cómo funcionará", pero el objetivo es que los evaluadores trabajen dentro de las empresas de IA "con un nivel de acceso comparable al de un empleado", y anticipió que estas usen a "varias organizaciones a la vez". "Para ser claros, los evaluadores integrados independientes no reducen nuestra responsabilidad, sino que contribuyen a que esta sea más verificable. La seguridad de nuestros modelos sigue siendo nuestra responsabilidad", indicó la firma de IA. Anthropic y Accenture planean invertir al menos 1.000 millones de dólares, respectivamente, durante cinco años, destinados a la "seguridad de la IA", pero la primera dijo que financiará "directamente" el trabajo de la segunda en este ámbito dada su "importancia y urgencia". EFE

InfobaeInfobaeNewsroom Infobae18 sept

Dario Amodei, el "evangelista de la seguridad" que lleva 10 años estudiando el apocalipsis de la IA

El CEO de Anthropic logró el apoyo de Altman, Musk y otras grandes figuras por su trayectoria investigando la seguridad de la IA, pero su empresa acumula algunos de los mayores escándalos del sector Un equipo de investigadores logra acceder a algoritmos secretos de OpenAI usando la IA de Anthropic Dario Amodei ha sido hasta ahora un gran desconocido para el gran público. Figuras como Sam Altman o Elon Musk han acaparado mucha más atención en las conversaciones sobre la inteligencia artificial. Amodei, sin embargo, podría ser el personaje más citado en este campo de la próxima década. Sobre todo, si el debate sobre la IA pasa a girar en torno a la posibilidad de que esta ataque a la humanidad, como ha ocurrido en la última semana. Amodei (San Francisco, 1983) lleva una década documentando en estudios académicos y ensayos todos los escenarios en los que eso podría ocurrir. Fue en 2016, siete años antes de la salida a la luz de ChatGPT, cuando publicó su primer gran estudio al respecto. Entonces, junto a otros cinco investigadores, alertó sobre los “comportamientos dañinos y no intencionados que surgen de un mal diseño de los sistemas” de aprendizaje automático, la tecnología entonces emergente que terminaría ayudando a desarrollar la IA generativa actual. A la humanidad se le está a punto de entregar un poder casi inimaginable, y no está nada claro si nuestros sistemas sociales, políticos y tecnológicos poseen la madurez para empuñarlo Dario Amodei Pero lo que entonces eran problemas relativamente concretos se convertiría en una preocupación mucho más amplia durante la década siguiente. Amodei fue ampliando el foco desde los riesgos técnicos a los escenarios apocalípticos. “A la humanidad se le está a punto de entregar un poder casi inimaginable, y no está nada claro si nuestros sistemas sociales, políticos y tecnológicos poseen la madurez para empuñarlo”, ha manifestado . Sus escritos están trufados de expresiones así: “La combinación de inteligencia, agencia, coherencia y escasa controlabilidad es plausible y representa una receta para el peligro existencial”. “Su tendencia a maximizar el poder los llevará a tomar el control de todo el mundo y sus recursos y, probablemente, como efecto secundario, a despojar de poder o destruir a la humanidad”, decía en el mismo ensayo, publicado en enero de 2026 y en el que ya anticipaba los riesgos de los agentes de IA. “Pienso y hablo mucho sobre los riesgos de la IA avanzada”, reconocía en otro de sus ensayos sobre la cuestión, publicado en 2024 . “Por ello, a veces se llega a la conclusión de que soy un pesimista o un catastrofista que cree que la IA será mayoritariamente mala o peligrosa. No lo creo en absoluto”, expone: “De hecho, una de las principales razones por las que me centro en los riesgos es que son lo único que nos separa de lo que considero un futuro fundamentalmente positivo. Creo que la mayoría de la gente subestima el potencial radical de la IA, así como también subestima la gravedad de sus riesgos”. Una de las principales razones por las que me centro en los riesgos es que son lo único que nos separa de lo que considero un futuro fundamentalmente positivo Dario Amodei A este tipo de perfiles, el sector tecnológico los denomina “evangelistas de la seguridad”. Ese es el término que utilizó para él, por ejemplo, el Financial Times , cuando detalló cómo su empresa, Anthropic, estaba sobrepasando a la líder del mercado, OpenAI. La diferencia es que esos evangelizadores suelen centrarse en la necesidad de establecer contraseñas fuertes o de formar a los empleados en los riesgos digitales. Amodei habla de que la IA suponga un peligro existencial para la sociedad. Y lo hace desde una posición única. “Los fundadores suelen ser expertos en tecnología, en desarrollo de productos o en ventas. Dario es uno de los pocos directores ejecutivos que he conocido que domina las tres áreas”, explicó al citado medio económico Divesh Makan, fundador de Iconiq Capital, que lideró una de las últimas rondas de financiación de Anthropic, hoy valorada en 2 billones de dólares (aproximadamente 1,75 billones de euros). El científico CEO El de Anthropic es, junto a Demis Hassabis (responsable de Google DeepMind), el único CEO de las grandes tecnológicas que ha trabajado como científico e investigador en la concepción de la IA actual. Una trayectoria muy diferente a la de Altman, especialista en la negociación de tratos con inversores y capital riesgo , o Elon Musk, cuyo perfil hace mucho que pasó a la dirección. Amodei, en cambio, llegó a la cima de una de las empresas más valiosas de la nueva industria de la IA después de pasar años haciendo investigación científica y dirigiendo algunos de los laboratorios que han marcado su desarrollo. Licenciado en física y doctorado en biofísica, su primer trabajo en el sector fue en Baidu, el principal buscador de China, en 2015, donde participó en el desarrollo de Deep Speech 2, uno de los primeros sistemas de reconocimiento de voz entre el inglés y el mandarín. Después saltó a Google Brain (el laboratorio de IA avanzada de la multinacional que posteriormente se fusionó con DeepMind para crear Google DeepMind) y más tarde, a OpenAI, a la que llegó avalado por aquel primer estudio sobre la seguridad del aprendizaje automático. Amodei, en una imagen de archivo “Dario fue uno de los autores principales de Deep Speech 2, un sistema de voz que logró un rendimiento casi humano en muchas tareas de habla. También es coautor de Problemas concretos en la seguridad de la IA , que pone de relieve cuestiones relacionadas con los accidentes en los sistemas de aprendizaje automático”, le presentó entonces OpenAI. Llegaría muy alto en la compañía. Mientras seguía publicando estudios científicos sobre la seguridad de la IA, llegó a ser vicepresidente de investigación y codirigió el desarrollo de GPT-2 y GPT-3, los grandes modelos de lenguaje de OpenAI que más tarde se convertirían en el motor de ChatGPT. Pero entonces decidió que su vocación por la seguridad era incompatible con la organización dirigida por Altman. “Dario siempre ha compartido nuestro objetivo de una IA responsable. Él y un grupo de colegas de OpenAI están planeando un nuevo proyecto que, según nos comentan, probablemente se centrará menos en el desarrollo de productos y más en la investigación”, comunicó entonces Altman. “Esperamos mantener una relación de colaboración con ellos durante muchos años”, continuaba. No serían muchos años, ya que el proyecto de Amodei tomaría forma en Anthropic, la empresa que ha arrebatado el liderazgo a OpenAI. Un laboratorio por la seguridad convertido en cuna de polémicas En 2021, Dario funda Anthropic junto a una persona clave para entender el desarrollo de la empresa: su hermana Daniela Amodei. Mientras que Dario se encarga de la investigación científica y la dirección estratégica de la compañía, Daniela se encarga de convertir su laboratorio en una organización empresarial. Y lo ha hecho con un enorme éxito, puesto que una de las claves del auge de Anthropic son sus cuentas. Mientras OpenAI sigue dilapidando miles de millones cada ejercicio, la compañía de los Amodei ha conseguido beneficios en los dos últimos trimestres. El leitmotiv que los hermanos crearon para su empresa es la seguridad en el desarrollo de la IA. “Realmente queríamos la oportunidad de reunir a ese grupo para hacer esta apuesta de investigación enfocada en construir sistemas de IA dirigibles, interpretables y confiables, con los humanos en el centro de ellos”, expresaba Daniela en una entrevista en 2022 . Es una trayectoria que ayuda a entender por qué Amodei se ha convertido en una de las voces con mayor autoridad dentro del sector para advertir sobre estos riesgos de la IA, , y por qué Altman, Musk o Hassabis llegaron a conceder que “Dario tiene razón” cuando el CEO de Anthropic presentó su plan para “ralentizar” la IA. Sin embargo, la realidad se ha empeñado en poner a prueba ese discurso. La empresa del “evangelista de la seguridad” es una de las que más escándalos acumula en los dos últimos años. A finales de 2025, Anthropic reconoció que su IA Claude fue utilizada por un grupo chino para intentar infiltrarse en unos 30 objetivos de todo el mundo. Recientemente, ha afirmado que ha detectado que otros actores vinculados a Irán y otros países desarrollaron herramientas de vigilancia, armas y otras operaciones digitales gracias a sus herramientas. En Anthropic comprenden lo que está en juego, pero están atrapados en una carrera por llegar primero: creen que nadie más actuará de manera responsable, por lo que deben hacerlo ellos mismos, a pesar del riesgo Jacob Coxon — Ex ingeniero de Anthropic y OpenAI El pasado julio, Anthropic dio a conocer que sus agentes de IA en pruebas habían escapado de un entorno controlado y circulado sin control por Internet antes de que pudieran ser desconectados. Y este viernes, un equipo de investigadores de ciberseguridad ha hecho público que se valió de Claude para explotar una brecha de seguridad en OpenAI, lo que les condujo hasta algunos de sus algoritmos secretos . El ingeniero Jacob Coxon, el responsable de la gran polémica de los últimos días acerca del peligro existencial de la IA, ha denunciado que no hay grandes diferencias entre Anthropic y OpenAI . “En Anthropic comprenden lo que está en juego, pero están atrapados en una carrera por llegar primero: creen que nadie más actuará de manera responsable, por lo que deben hacerlo ellos mismos, a pesar del riesgo”, ha explicado: “Ninguna de las dos compañías está actuando de manera responsable. Están corriendo directamente hacia una superinteligencia capaz de mejorarse a sí misma y apostando nuestras vidas en esa carrera”. Dario Amodei ha defendido la necesidad de regular la IA e intentado evitar que sus herramientas se usen para programar armas autónomas o la vigilancia masiva. Mantuvo esa postura incluso ante los embates de Donald Trump, que le tachó de “loco izquierdista” , e intentó coaccionar a su empresa prohibiéndola tener relaciones con la administración . Durante una década, Amodei ha documentado cómo puede salir mal la IA. Ahora su empresa está en el centro de algunos de los episodios que ponen esos riesgos a prueba.

elDiario.eselDiario.esCarlos del Castillo18 sept
I

La IA se abre paso en la ONU entre diferencias de Estados Unidos, China y la UE

Naciones Unidas, 18 sep (EFE).- La inteligencia artificial (IA) se abrirá paso en los debates de la 81ª Asamblea General de Naciones Unidas en un momento marcado por los llamamientos a ralentizar su desarrollo, en medio de la pugna entre Estados Unidos y China por el liderazgo tecnológico y los esfuerzos de Europa para no quedar relegada. Francia, que ejerce este mes la presidencia rotatoria del Consejo de Seguridad, prepara además una reunión sobre IA y seguridad durante la semana de alto nivel de la Asamblea, que comienza el martes, aunque la fecha y el formato todavía están por confirmar. El debate sobre los riesgos del rápido desarrollo de la IA se ha intensificado en los últimos días después de que el consejero delegado de Anthropic, Dario Amodei, pidiera ralentizar el desarrollo de los sistemas más avanzados y reforzar la seguridad, propuesta respaldada por otros líderes del sector como Sam Altman, de OpenAI, que además retrasó la salida a bolsa de su compañía. La semana de alto nivel coincidirá también con la visita del presidente chino, Xi Jinping, a Washington el próximo día 24, para reunirse con su homólogo, Donald Trump, en unas conversaciones en las que la IA forma parte de las grandes diferencias entre ambas potencias. Mientras Trump insiste en que cualquier freno al desarrollo de la IA beneficia a China, Pekín acelera sus propios modelos y cuestiona las propuestas estadounidenses para limitar el avance de esta tecnología. En ese contexto, el secretario del Tesoro estadounidense, Scott Bessent, se reunirá este fin de semana con el viceprimer ministro chino, He Lifeng, en unas conversaciones que incluirán la IA y sus riesgos, según el medio Axios. Pero la pugna entre Washington y Pekín no se limita a quién desarrolla los modelos de IA más avanzados, sino que también está en juego el acceso a los chips más sofisticados, los centros de datos, la capacidad de computación y la energía necesaria para alimentarlos. China no estará representada por Xi en el debate de alto nivel de la Asamblea y en su lugar se espera que intervenga el vicepresidente Han Zheng el sábado 26. Entretanto, la Unión Europea (UE) busca encontrar su propio espacio y este año ha comenzado a aplicar su marco de supervisión de la inteligencia artificial, establecido por la Ley de IA de la UE (AI Act), aunque también ha simplificado parte de sus normas para favorecer la innovación y la competitividad. Bruselas quiere establecer salvaguardas para la tecnología sin quedar al margen de una carrera en la que Estados Unidos y China llevan ventaja. En ese contexto, la presidenta del Banco Central Europeo (BCE), Christine Lagarde, advirtió esta semana del riesgo de que Europa quede expuesta por su dependencia de tecnologías e infraestructuras extranjeras y reclamó que desarrolle sus propios modelos de IA y centros de datos. Y la presidenta de la Comisión Europea, Ursula von der Leyen, aprovechó esta semana su discurso sobre el Estado de la Unión para defender una doble estrategia: reforzar las salvaguardas ante los riesgos de los modelos más avanzados y, al mismo tiempo, aumentar la capacidad tecnológica europea. Von der Leyen calificó la Ley de IA como una "pieza crucial" para establecer esas salvaguardas y anunció que invitará a los principales laboratorios de IA a debatir cómo apoyar los esfuerzos de la industria para "acompasar" el desarrollo de los modelos más avanzados. Entretanto, Naciones Unidas busca construir un marco multilateral para la tecnología, y el nuevo presidente de la Asamblea General, Khalilur Rahman, ha defendido que los Gobiernos deben "empezar ya a trabajar en una gobernanza de la IA basada en el acceso equitativo, la seguridad, la rendición de cuentas y la supervisión humana". Por su parte, el secretario general, António Guterres, advirtió esta semana de los riesgos asociados al rápido desarrollo de la IA y defendió la necesidad de "una respuesta internacional para garantizar su seguridad" y evitar que la carrera tecnológica se desarrolle sin reglas comunes. El primer diálogo mundial sobre gobernanza de la IA se celebró el pasado julio en Ginebra y el segundo está previsto para mayo de 2027 en Nueva York. A ese mecanismo se suma un panel científico internacional independiente, encargado de abordar e las oportunidades y los riesgos de la IA y de servir de apoyo a los Gobiernos en la elaboración de futuras reglas. Para muchos países, especialmente los más vulnerables, el reto será garantizar el acceso a la IA y tener voz en las reglas que definirán su impacto sobre el empleo, la desigualdad y el desarrollo. EFE

InfobaeInfobaeNewsroom Infobae18 sept

Anthropic propone tres mediciones para comprender el ritmo de desarrollo de la IA

Anthropic ha compartido las tres mediciones con las que considera que se puede ofrecer una mejor comprensión del ritmo de desarrollo de la inteligencia artificial (IA) de frontera, ante la amenaza que supone el hecho de que estos sistemas sean cada vez más potentes y hayan comenzado a automatizar gran parte de su propio desarrollo. La advertencia hecha recientemente por el director ejecutivo de Anthropic, Dario Amodei, sobre la necesidad de frenar el desarrollo de la IA de frontera por el riesgo de daño que tienen las capacidades avanzadas para la sociedad, encuentra sus motivos en la desalineacion y la automejora recursiva. El primer concepto hace referencia al comportamiento de la IA que no se ajusta a lo esperado, en base a valores, intereses o intenciones humanas. La automejora recursiva, por su parte, es una técnica que permite que un sistema de IA diseñe y desarrolle de forma autónoma a su sucesor. Ambos conceptos requieren nuevas mediciones que permitan ofrecer "una mejor comprensión del ritmo de desarrollo de la IA en los laboratorios de vanguardia", con el objetivo de "esclarecer" tres puntos que en Anthropic consideran "críticos". Se trata de constatar lo avanzada que está la autoconstrucción de una nueva versión de la IA, la capacidad de la empresa para supervisar e intervenir en las acciones que los agentes realicen en sus sistemas y la capacidad de cómputo necesaria para desarrollar los modelos más capaces. "Al comprender mejor el proceso de producción de modelos, tenemos más posibilidades de correlacionar las entradas del modelo, como la capacidad de cómputo, con las salidas del modelo, como las capacidades", afirma la compañía en un comunicado. MEDICIÓN DE LA AUTOMATIZACIÓN DEL DESARROLLO La compañía considera que "la aceleración del desarrollo de los modelos podría dificultar su comprensión y control por parte de los humanos" y, por ello, "mide la proporción de la investigación y el desarrollo en IA de Anthropic que realiza Claude" con el Índice de Automatización de I+D de Anthropic. Este índice les ha permitido descubrir que, desde agosto del presente año, Claude "lidera el 26% del trabajo de I+D en inteligencia artificial de Anthropic". Además, la colaboración de esta inteligencia artificial supera el 90 por ciento. MEDICIÓN DE LA SUPERVISIÓN DE AGENTES Aunque la monitorización que han realizado hasta ahora ha mostrado que "los agentes individuales rara vez se comportan de forma indebida", Anthropic es consciente de que "a medida que el trabajo se automatiza, los agentes podrían tomar decisiones de mayor trascendencia". A partir del análisis de más de 30.000 agentes de investigación e ingeniería que operaban simultáneamente en su plataforma interna mediante tres métricas principales: cobertura, latencia y tasa de escalado, detectaron que de más de mil millones de decisiones analizadas, solo el 0,002% (1 de cada 47.000) fue bloqueado por los monitores 'online'. Por su parte, el monitor 'offline' marca entre uno y dos registros por cada mil para posterior análisis. MEDICIÓN DE LA ASIGNACIÓN DE CÓMPUTO En este apartado, Anthropic aborda el análisis de cómo las empresas de IA distribuyen sus recursos de cálculo y, en particular, qué proporción se dedica a la investigación en seguridad. Esto permite conocer en qué áreas enfoca sus recursos una empresa y cómo cambia esta prioridad con el tiempo, aunque hace la matización de que la investigación en seguridad suele requerir menos cómputo que el entrenamiento de modelos frontera masivos. En su análisis, realizado durante una semana (del 13 al 20 de julio de 2026), mostró que el 6 por ciento del cómputo dedicado a I+D de IA se destinó a trabajos de seguridad (como alineamiento, interpretabilidad o pruebas de evaluación), mientras que el 12 por ciento del cómputo guiado por agentes de IA en tareas de I+D se asignó específicamente a proyectos de seguridad.

InfobaeInfobaeNewsroom Infobae18 sept